
บางทีคุณอาจเคยได้ยิน FaceApp แอปพลิเคชั่นแก้ไขรูปภาพบนมือถือที่ได้รับความสนใจอย่างมากทั่วโลกพร้อมความสามารถในการใช้ปัญญาประดิษฐ์ (AI) เพื่อแก้ไขเซลฟี่ด้วยความถูกต้องระดับสูงอย่างยิ่ง หรือบุคคลนี้ไม่มีอยู่จริง อีกหนึ่งแอปแก้ไขรูปภาพที่สามารถสร้างภาพบุคคลที่น่าสนใจโดยอิงจากตัวละครกราฟิกที่สร้างขึ้นจากคอมพิวเตอร์ นี่เป็นเพียงสองแอปพลิเคชันที่ยอดเยี่ยมที่มี AI ในงานที่เกี่ยวข้องกับการแก้ไขและการสร้างสรรค์ภาพ แล้วการตัดต่อวิดีโอล่ะ?
เมื่อเร็วๆ นี้ DeepMind ซึ่งเป็นบริษัทในเครือของ Alphabet ซึ่งดำเนินงานในด้านการพัฒนาปัญญาประดิษฐ์เป็นหลัก ได้ประกาศสิ่งประดิษฐ์ใหม่ที่เรียกว่า "การสร้างวิดีโอที่มีประสิทธิภาพบนชุดข้อมูลที่ซับซ้อน" ซึ่งเป็นวิดีโอที่ใช้ชุดข้อมูลที่ซับซ้อนได้อย่างมีประสิทธิภาพ) สัญญาว่าจะนำมาซึ่งการเปลี่ยนแปลงมากมายใน สาขาการตัดต่อวิดีโอและหลังการผลิตในอนาคต โดยพื้นฐานแล้วนี่เป็นอัลกอริธึม AI ที่สามารถเรียนรู้วิธีสร้างคลิปง่ายๆ จากวิดีโอที่ถูกเปิดเผยในระหว่างกระบวนการฝึกอบรม
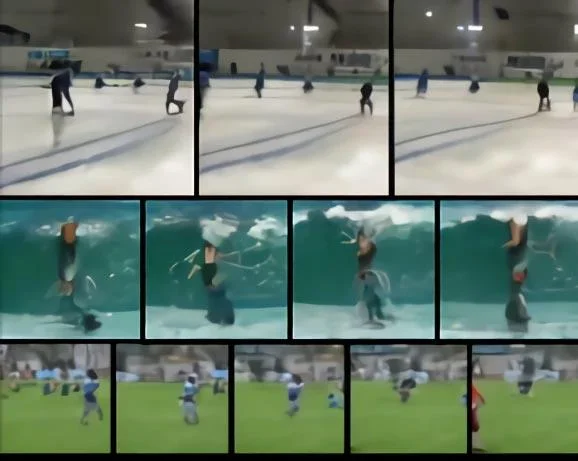 ขณะนี้ DVD-GAN สามารถสร้างวิดีโอตัวอย่างที่มีเค้าโครงออบเจ็กต์แบบเต็มได้โดยอัตโนมัติ
นักวิจัยที่ DeepMind กล่าวว่า Dual Video Discriminator GAN (DVD-GAN) ที่มีประสิทธิภาพดีที่สุดในปัจจุบัน สามารถสร้างวิดีโอที่ความละเอียด 256 x 256 พิกเซล รวมกับความละเอียดสูงได้ ความเที่ยงตรงเป็นที่ยกย่องและความยาวก็เพิ่มขึ้น ถึง 48 เฟรม
“การสร้างวิดีโอที่มีความเป็นธรรมชาติและความสมจริงในระดับสูงถือเป็นความท้าทายที่ยิ่งใหญ่ที่สุดสำหรับโมเดล AI ในปัจจุบัน ในบรรดาปัจจัยเหล่านั้น ปัจจัยที่เป็นอุปสรรคที่สำคัญที่สุดไม่ใช่ใครอื่นนอกจากความซับซ้อนของข้อกำหนดในการรวบรวมข้อมูลและการคำนวณ ด้วยเหตุนี้ งานจำนวนมากที่เกี่ยวข้องกับการสร้างวิดีโอในอดีตจึงมักเกี่ยวข้องกับชุดข้อมูลที่ค่อนข้างง่าย หรืองานที่มีข้อมูลแบบเรียลไทม์ ขณะนี้ เรากำลังมุ่งเน้นไปที่การสังเคราะห์วิดีโอและการทำนายงาน และมีเป้าหมายที่จะขยายผลลัพธ์ของโมเดล AI การสร้างภาพชั้นนำในปัจจุบันไปยังวิดีโอ ซึ่งในด้านที่ซับซ้อนดีขึ้นมาก” ตัวแทนของทีมวิจัยกล่าว
ทีมงานสร้างระบบโดยใช้สถาปัตยกรรม AI ขั้นสูง ขณะเดียวกันก็แนะนำการปรับแต่งเฉพาะวิดีโอจำนวนหนึ่ง ซึ่งช่วยให้กระบวนการฝึกอบรมดำเนินการตาม Kinetic-600 ได้ - ชุดข้อมูลประกอบด้วยวิดีโอ "ธรรมชาติ" ซึ่งมีขนาดใหญ่กว่ามากใน ขนาดมากกว่าปกติ โดยเฉพาะอย่างยิ่ง นักวิจัยได้ใช้ประโยชน์จากเครือข่ายปฏิปักษ์ทั่วไป (GAN)
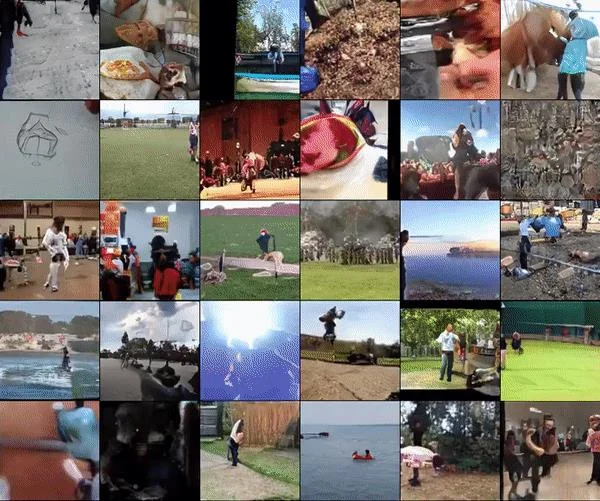 ชุดคลิปวิดีโอสังเคราะห์ความยาว 4 วินาทีที่ฝึกในขนาด 12 128 × 128 เฟรมจาก Kinetic-600
หากคุณไม่รู้ GAN คือระบบ AI ที่ประกอบด้วย 2 ส่วนแยกกัน ส่วนแรกคือ Generative Network ซึ่งช่วยสร้างตัวอย่างการฝึก (ข้อมูลปลอม) โดยมีเป้าหมายเพื่อสร้างข้อมูลการฝึกสร้างความคล้ายคลึงที่สมจริงที่สุด . และประการที่สองคือเครือข่าย Discriminative ซึ่งพยายามแยกแยะระหว่างข้อมูลจริงและข้อมูลปลอม ระบบ GAN ถูกนำไปใช้ในงานที่เข้มข้นหลายอย่าง เช่น การแปลงคำบรรยายให้เป็นเรื่องราวตามบริบท โดยเฉพาะการสร้างภาพถ่ายเทียมที่มีความสมจริงสูงมาก
DVD-GAN มีเครือข่ายแบบเลือกปฏิบัติแบบคู่: อัลกอริธึมแบบเลือกปฏิบัติสามารถเปิดเผยความแตกต่างในเนื้อหาและโครงสร้างของเฟรมเดียวได้โดยการสุ่มตัวอย่างเฟรมที่มีความละเอียดเต็ม จากนั้นจึงประมวลผล การประมวลผลทีละรายการและแยกความแตกต่างเมื่อเวลาผ่านไปจะเป็นตัวชี้นำการเรียนรู้สำหรับการสร้างการเคลื่อนไหว โมดูลเดียวชื่อ Transformer ช่วยให้สามารถกระจายข้อมูลที่เรียนรู้และสารสนเทศทั่วทั้งโมเดล AI ทั้งหมด
สำหรับคลังข้อมูลการฝึกอบรม Kinetic-600 นี่เป็นชุดข้อมูลขนาดยักษ์ที่รวบรวมจากคลิป YouTube ความละเอียดสูงกว่า 500,000 คลิปในระยะเวลาไม่เกิน 10 วินาที วิดีโอเหล่านี้ได้รับการดูแลจัดการในตอนแรกเพื่อจดจำการกระทำของมนุษย์ โดยนักวิจัยอธิบายว่าคลังข้อมูลนี้เป็นปัจจัยที่ "หลากหลาย" และ "ไม่มีข้อจำกัด" ซึ่งมีความเกี่ยวข้องอย่างยิ่งในการฝึกอบรม โมเดลเปิดที่คล้ายกับ DVD-GAN ของ DeepMind (ในด้านแมชชีนเลิร์นนิงมีคำว่า “overfitting” ซึ่งใช้เรียกโมเดลที่ใกล้เคียงกับชุดข้อมูลใดชุดหนึ่งมากเกินไปจนส่งผลให้ไม่สามารถคาดการณ์การสังเกตในข้อมูลได้ในอนาคตได้อย่างน่าเชื่อถือ) .
ตามรายงานของทีมวิจัย หลังจากได้รับการฝึกอบรมอย่างต่อเนื่องโดยระบบ Tensor Processing Units รุ่นที่ 3 ของ Google เป็นระยะเวลา 12 ถึง 96 ชั่วโมง ขณะนี้ DVD-GAN ก็สามารถสร้างวิดีโอได้ด้วยตัวเอง โมเดลนี้มีเค้าโครงวัตถุ การเคลื่อนไหว และ แม้แต่โครงสร้างที่ซับซ้อน เช่น การสะท้อนบนพื้นผิวแม่น้ำ ลานสเก็ตน้ำแข็ง... DVD-GAN ต้อง "ดิ้นรน" เพื่อสร้างวัตถุที่ซับซ้อนในบริเวณนี้ ซึ่งมีความละเอียดสูงกว่า ซึ่งการเคลื่อนไหวเกี่ยวข้องกับจำนวนพิกเซลที่ใหญ่กว่ามาก อย่างไรก็ตาม นักวิจัยตั้งข้อสังเกตว่าหลังจากได้รับการประเมินใน UCF-101 (ชุดข้อมูลขนาดเล็กที่มีวิดีโอการกระทำของมนุษย์ 13,320 รายการ) ตัวอย่างวิดีโอที่สร้างโดย DVD-GAN ก็ทำคะแนนได้ดี คะแนน Inception อยู่ที่ 32.97 ซึ่งถือว่าไม่แย่เลย
 ตัวอย่างวิดีโอที่ DVD-GAN สร้างขึ้นมีคะแนนเริ่มต้นที่ 32.97
“จากนี้ไป เราต้องการเน้นย้ำถึงประโยชน์ของการฝึกอบรมโมเดลการสร้างบนชุดข้อมูลวิดีโอขนาดใหญ่และซับซ้อน เช่น Kinetic-600 แม้ว่ายังมีงานอีกมากที่ต้องทำก่อนที่จะสามารถสร้างวิดีโอที่สมจริงได้อย่างต่อเนื่องในการตั้งค่าที่ไม่จำกัด แต่เราเชื่อว่า DVD-GAN เป็นก้าวที่สมบูรณ์แบบในการทำให้ความฝันนี้เป็นจริง” ตัวแทนของ ทีมวิจัย
คุณคิดอย่างไรกับโมเดล DVD-GAN AI ของ DeepMind กรุณาแสดงความคิดเห็นของคุณด้านล่าง!





