
현실적으로 AI가 하나 이상의 텍스트로 원본 클립을 만들 수 있다는 사실은 기술 세계에서 엄청난 뉴스가 아닙니다. 작년에 연구자들은 시스템이 생물학적 신경망(뉴런)을 모델로 한 수학적 기능의 계층인 신경망을 활용하여 정보 조각을 생성하는 방법을 자세히 설명했습니다. 비디오는 길이가 32프레임이고 크기가 64×64픽셀입니다. "잔디밭에서 축구하는 것"처럼요. 그러나 Arxiv.org에 게재된 새로운 기사에 따르면 Disney Research와 Rutgers의 과학자들은 크로스 워드 AI 모델을 사용하여 이 아이디어를 한 단계 더 발전시키는 데 성공했습니다. 처음부터 끝까지 대략적인 플롯을 만드는 것이 가능합니다. 각본의 텍스트에 대한 비디오 설명도 포함됩니다. 특히 과학자들의 텍스트-애니메이션 모델은 활동에 대한 설명 입력 텍스트를 제공하는 데 사용되는 예비 단계인 주석 데이터 없이 애니메이션을 만드는 데 도움이 됩니다.
“자연어 텍스트에서 애니메이션을 자동으로 생성하는 것은 영화 대본 작성이나 교육용 비디오 제작 등 다양한 분야에 적용할 수 있는 매우 유용한 기술입니다. 이러한 AI 시스템은 더 빠른 반복, 프로토타이핑 및 개념 증명을 가능하게 하여 스크립팅에 적용할 때 특히 유용합니다. 본 연구에서 우리는 복잡한 문장을 만족스럽게 처리할 수 있는 텍스트-애니메이션 시스템을 성공적으로 개발했습니다. 이번 AI 시스템의 목적은 작가나 시나리오 작가를 완전히 대체하는 것이 아니라 시나리오 작가의 작업을 효과적으로 지원하고 더 쉽고 재미있게 만들 수 있는 AI 비서를 만드는 것”이라고 연구팀은 밝혔다.
연구원들이 설명했듯이 텍스트를 애니메이션으로 번역하는 것은 간단한 작업이 아닙니다. 실제로 문장(입력 데이터)과 애니메이션(출력 데이터) 모두 고정된 구조를 갖고 있지 않습니다. 이는 또한 대부분의 최신 텍스트-비디오 도구가 복잡한 문장 패턴을 처리할 수 없는 이유이기도 합니다. 현재 시스템의 한계를 해결하기 위해 연구팀은 다음과 같은 여러 구성 요소를 포함하는 모듈식 신경망을 구축했습니다. 스크립트의 장면 설명에서 관련 텍스트를 자동으로 동적으로 분리하는 새로운 스크립트 구문 분석 모듈; 일련의 언어 규칙을 사용하여 복잡한 문장 패턴을 단순화하고 단순화된 문장으로부터 정보를 미리 정의된 동작 표현으로 추출하는 자연어 처리 모듈; 및 상기 표현을 다중 애니메이션 시퀀스로 변환하는 역할을 하는 애니메이션 모듈을 포함한다.
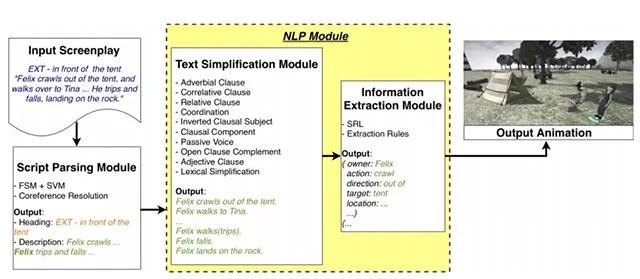
연구원에 따르면 이러한 단순화된 접근 방식을 사용하면 핵심 스크립트 정보를 훨씬 쉽게 추출할 수 있으며, 해당 시스템은 코드 조각에 특정 구문 구조가 제공되는 시기를 자동으로 식별한 다음 이를 더 간단한 문장으로 분해 및 조립할 수 있습니다. 더 이상 단순화할 수 없을 때까지 재귀적으로 처리합니다. 다음 "조정 단계"는 동일한 구문 관계를 가지며 동시에 동일한 기능적 역할을 수행하는 문장에 적용됩니다. 그리고 마지막으로 문장에 설명된 동작과 일치하는 어휘 시뮬레이터는 미리 정의된 라이브러리에 있는 52개의 애니메이션(동의어 사전을 사용하여 92개의 애니메이션으로 확장 가능)으로 단순화됩니다.
그런 다음 Cardinal이라는 시스템이 이러한 애니메이션을 액션의 입력으로 사용하고 Epic Games에서 개발한 인기 비디오 게임 엔진인 Unreal에서 사전 시각화를 생성합니다. 사전 정의된 애니메이션 라이브러리를 기반으로 캐릭터 생성에 사용할 수 있는 개체와 모델이 사전 로드되어 처리된 시나리오에 충실하게 묘사되는 3D 애니메이션 비디오를 만드는 데 도움이 됩니다.

이 우수한 시스템을 훈련하기 위해 연구원들은 IMSDb, SimplyScripts 및 ScriptORama5를 포함하여 무료로 제공되는 소스에서 가져온 1,000개 이상의 스크립트를 바탕으로 996개의 시나리오로 구성된 장면 설명 데이터베이스를 컴파일하기 시작했습니다. 전체적으로 이 자료에는 1,402,864개의 문장을 포함하는 525,708개의 설명이 포함되어 있으며, 그 중 920,817개(40% 이상)에는 동작을 설명하는 동사가 하나 이상 있습니다.
질적 실험에서 과학자들은 22명의 참가자에게 20개의 시스템 생성 애니메이션을 5점 척도로 평가하도록 요청했습니다(예: 비디오가 텍스트 내용을 고려할 때 적절하게 애니메이션으로 표시됩니까? 텍스트? 또는 비디오에 얼마나 많은 텍스트 정보가 설명되어 있습니까?) 비디오의 정보가 텍스트에 얼마나 많이 언급되었는지), 참가자의 68%는 시스템이 효과적인 애니메이션을 생성했다고 말했습니다. 입력 시나리오의 공정한 가치 - 특별히 높은 비율은 아니지만 매우 칭찬할 만합니다.
이는 이것이 실제로 완벽한 시스템이 아니라는 것을 보여줍니다. 실제로 동작 및 해당 객체의 목록은 완전하지 않으며 때로는 어휘 단순화 프로세스가 복잡한 동사를 유사한 애니메이터에 성공적으로 매핑할 수 없거나 원래 문장에 여러 주제가 있는 동사에 대해 몇 가지 간단한 문장만 만들 수 있습니다. . 그러나 이는 아직 초기 단계의 연구이므로 그러한 제한점은 충분히 이해할 수 있습니다. 연구진은 가까운 시일 내에 위의 단점을 해결할 계획이다.

“내부 및 외부 평가에서 이 시스템의 합리적인 성능이 입증되었으며, 텍스트 조각에 설명된 일련의 작업을 검토하여 담화 정보를 활용하고 싶었습니다. 이는 또한 작업과 관련된 텍스트의 모호성을 해결하는 데 도움이 됩니다. 또한 우리 시스템은 유사한 엔드투엔드 신경 시스템을 훈련하는 데 필요한 데이터를 생성하는 데 사용될 수 있습니다.”라고 팀은 말했습니다.





