
Excelは、3つ以上のサンプルがある場合に役立つ方法を知っています。FarKlempt Robotics、Inc。は、従業員の仕事に対する満足度を調査しています。彼らは、開発者、マネージャー、保守作業員、およびテクニカルライターに、仕事の満足度を1(最も満足度が低い)から100(最も満足度が高い)のスケールで評価するように依頼します。
各カテゴリーには6人の従業員がいます。次の画像は、列AからD、行1〜7のデータを含むスプレッドシートを示しています。帰無仮説は、サンプルがすべて同じ母集団からのものであるというものです。対立仮説は、そうではないというものです。
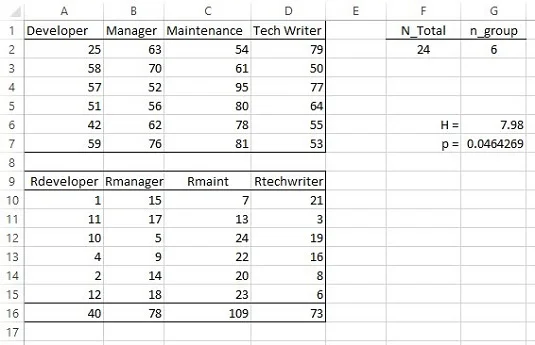
クラスカル・ウォリス一元配置分散分析。
適切なノンパラメトリック検定は、クラスカル・ウォリス一元配置分散分析です。24のスコアすべてを昇順でランク付けすることから始めます。繰り返しますが、帰無仮説が真の場合、ランクはグループ全体にほぼ均等に分散される必要があります。
この統計の式は次のとおりです。

Nはスコアの総数、nは各グループのスコアの数です。簡単にするために、各グループに同じ数のスコアを指定しますが、このテストでは必要ありません。Rは、グループ内のランクの合計です。Hは、各nが5より大きい場合、df =グループの数— 1のカイ2乗としてほぼ分布します。
画像を振り返ると、データのランクは列AからDの行9〜15にあります。行16は、各グループのランクの合計を保持します。N_Totalを、スコアの総数であるセルF2の値の名前として定義します。n_groupを、各グループのスコア数であるG2の値の名前として定義します。
Hを計算するには、次のように入力します
=(12 /(N_Total *(N_Total + 1)))*(SUMSQ(A16:D16)/ n_group)-3 *(N_Total + 1)
セルG6に。
仮説検定の場合は、次のように入力します
= CHISQ.DIST.RT(G6,3)
G7に。結果は.05未満であるため、帰無仮説を棄却します。




